中文研究笔记
JustQuant:革命性简单、强大的模型量化方法
仅用纯低比特矩阵算子达到强大的模型质量与部署潜力。
量化研究里有一个越来越熟悉的时刻:一篇新论文带着更小的模型、更低的比特数和更大的加速比出现。表格比上一张更漂亮。然后有人问了一个真正影响使用的问题:
Kernel 在哪里?
很多时候,答案并不如论文里的数字那样令人满意。模型可能需要在矩阵乘法前做一次 rotation,在之后接一个低秩分支,旁边再放一个 smoothing 操作,或者依赖一种只有最新、最昂贵的加速卡才能高效支持的数值格式。论文展示的是一个紧凑的模型,真正部署时却继承了一整套复杂的软件系统。
这正是 JustQuant 想解决的问题。
比特数不是全部
低比特研究已经取得了非常大的进展。但与此同时,从学术论文里的算子到真正可用的部署原语之间的距离也越来越明显。
一个激活量化模型在论文里可能只有 4 bit,但推理时仍然需要一连串难以融合、难以迁移、也难以在不同硬件上跑快的变换。问题不在于 SVD、rotation、smoothing 或新的数值格式本身是错误的,它们有时确实很有用。问题在于,每增加一个操作,就等于增加了一条部署契约:有人必须实现它、融合它、测试它、迁移它,并在下一代硬件上继续维护它。
而现实世界远不只有最新的数据中心 GPU。很多用户使用的是较老的 NVIDIA 显卡、工作站加速卡,或者国产加速器。对于这些设备来说,如果一个方法依赖某个特殊实现,那么它可能在一台机器上效果很好,在另一台机器上却几乎无法使用。
因此我们提出了一个刻意朴素的问题:
我们能不能真正把一个模型训练进由普通低比特矩阵乘法组成的网络里?
这里的“普通”指的是 naive W4A4 或 W1.58A4 矩阵算子:推理时不需要 rotation,不需要 SVD 分支,也不需要 smoothing。必要的复杂度应该转移到训练阶段,而部署后的计算图应该保持简单、清晰、容易实现。
JustQuant
JustQuant 是一套实现这一目标的训练方法。它使用 渐进式蒸馏(progressive distillation),让一个从一开始就受到低比特约束的 student,逐渐学习 full-precision teacher 的行为。
核心想法很简单:不要让一个脆弱的小型量化模型一步模仿完整的 teacher。先让较短的量化片段表现正确,再逐渐延长片段,最后扩展到完整模型。局部监督逐步成长为全局监督。
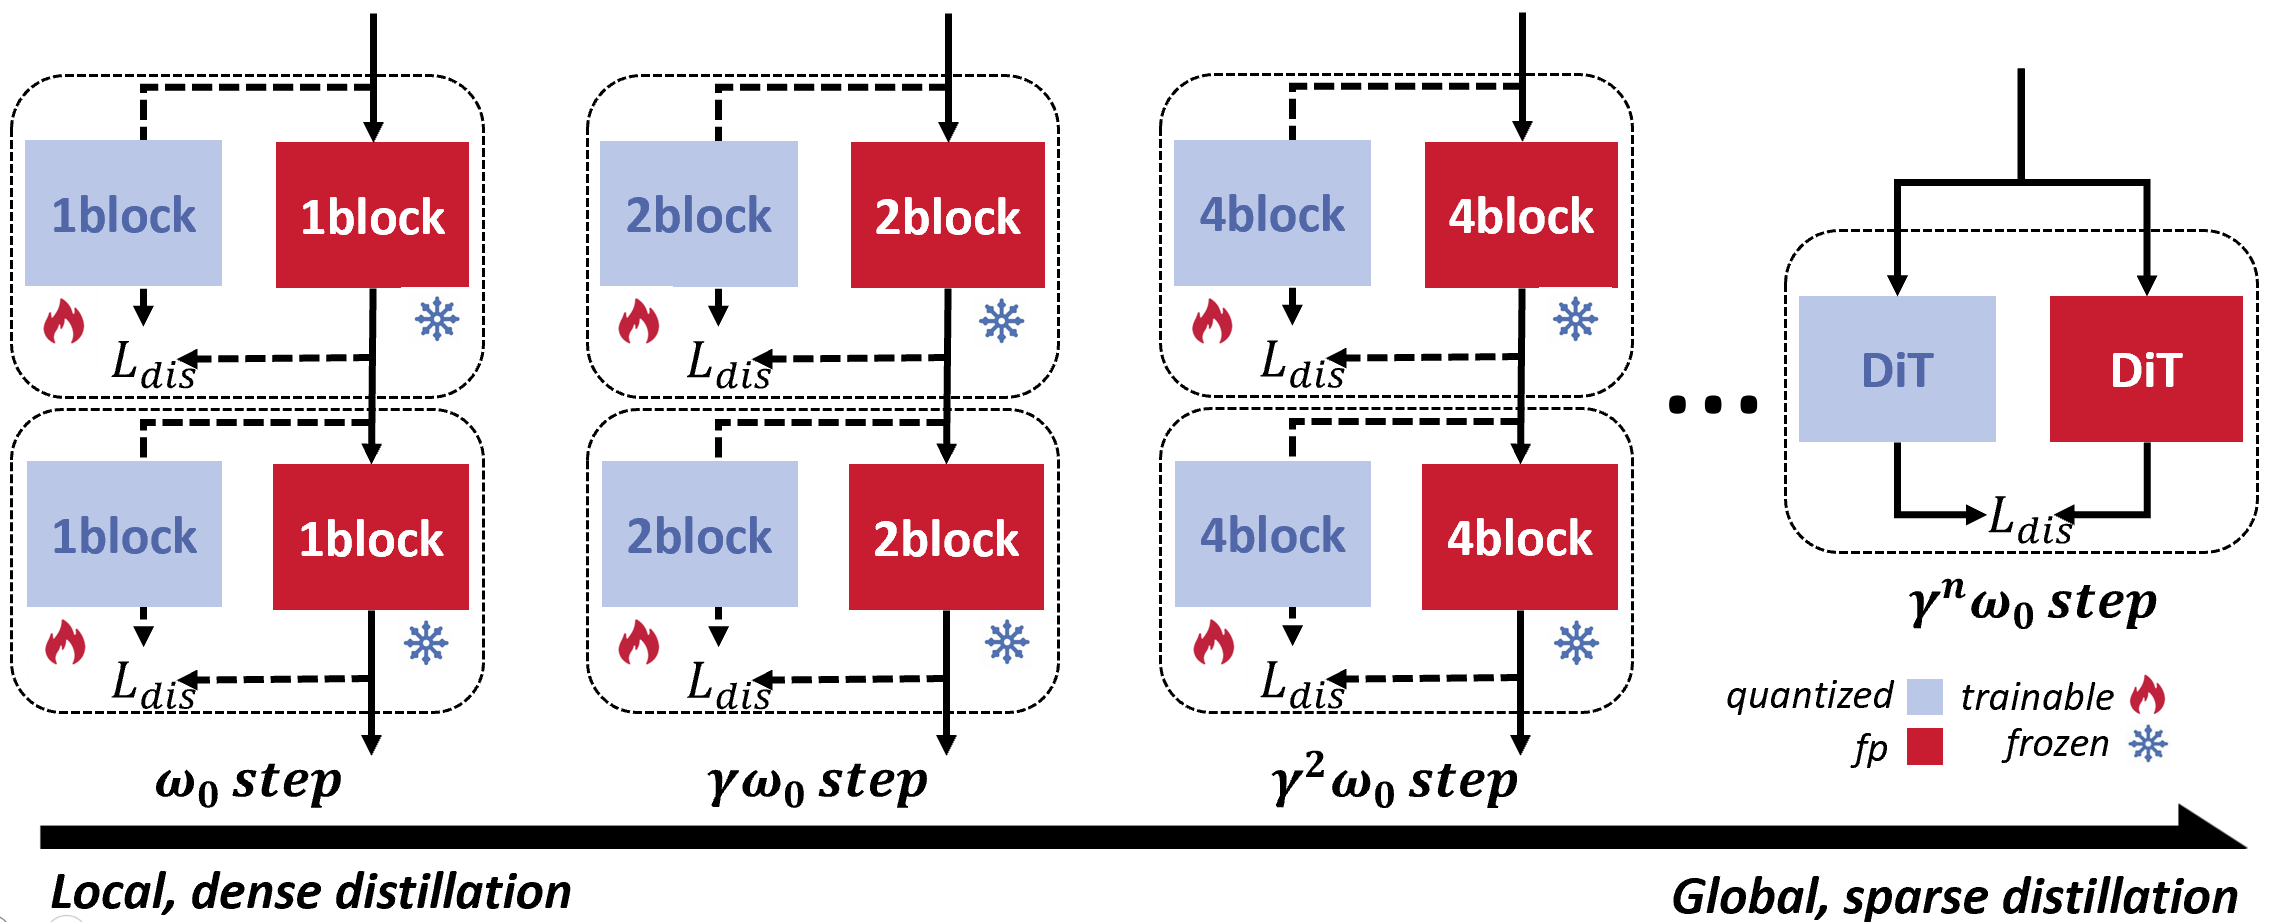
这个方法的名字来自忒修斯之船:如果一艘船的每块木板都被替换了,它还是原来的那艘船吗?对模型而言,对应的问题是:如果每一步计算都换成低比特计算,是什么让模型仍然保留原来的智能?
简单的算子也可以很强
第一个答案来自 FLUX.1,这是一个 120 亿参数的文生图模型。
在 FLUX.1-schnell 上,仅使用 naive W4A4,JustQuant 达到了 17.62 FID 和 0.993 ImageReward。full-precision BF16 参考结果是 19.15 FID 和 0.959 ImageReward。在我们测试的基线中,这个纯粹的低比特路径不仅具有竞争力,在这些指标上还优于加入 rotation 或 SVD 变换的方法。
在 FLUX.1-dev 上,同样的 naive W4A4 配置达到 20.21 FID 和 0.956 ImageReward,接近 BF16 的 20.26 和 0.958。这不是一种特殊的硬件格式,而是一条可以建立在普通 W4A4 GEMM 之上的低比特矩阵路径。
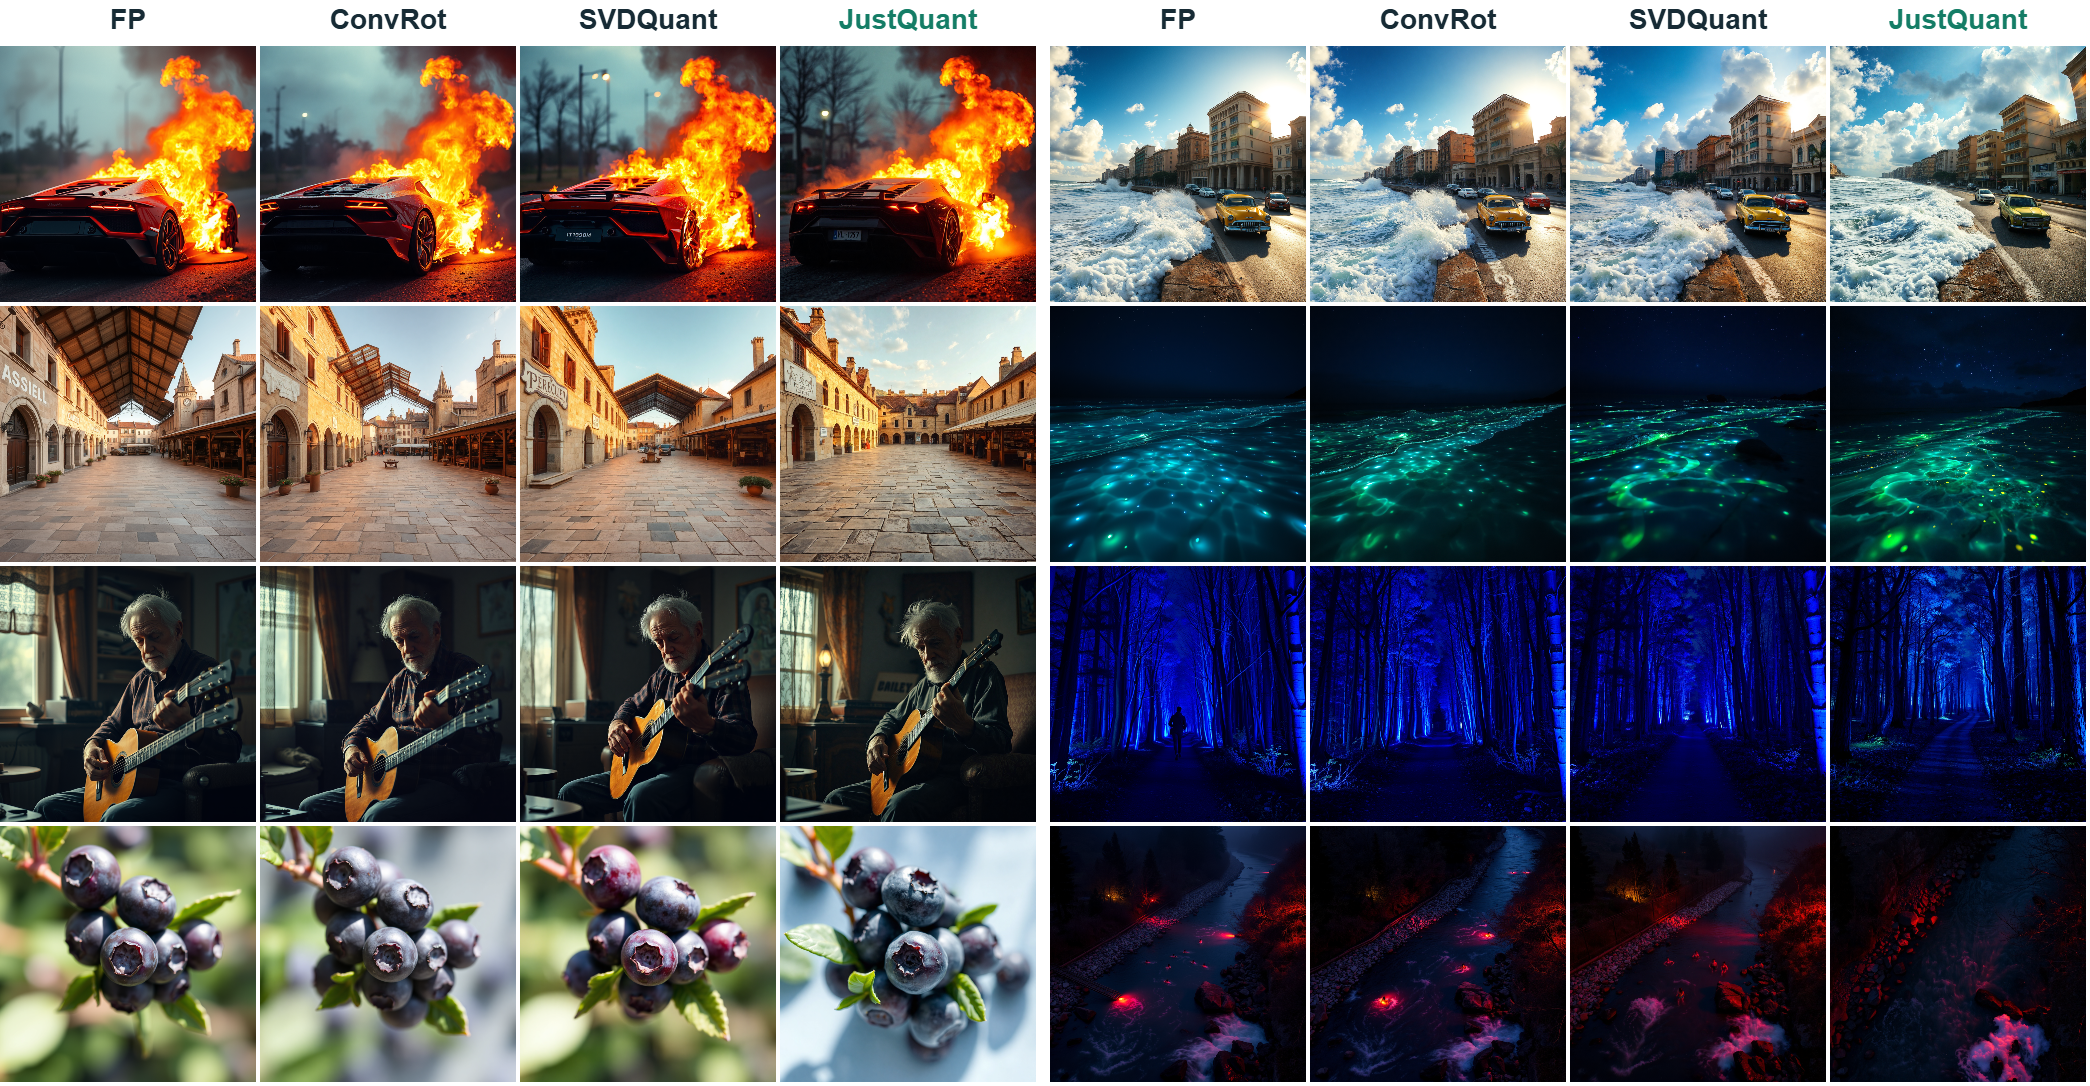
训练成本同样值得放进讨论里。FLUX 实验大约使用 4 张 H200 GPU 训练 18 小时。这当然不是零成本,但相比为每一种特殊算子和每一种机器编写、维护新的部署 kernel,这可能是一种更容易迁移的投入。
更小的模型,才是更难的测试
大模型拥有更多冗余,往往更容易容忍量化误差。小模型则没有那么多隐藏空间。这也是量化感知蒸馏经常变得不稳定的地方:一个在大模型上有效的方法,换到只有 0.6B 参数的模型上可能就会崩溃。
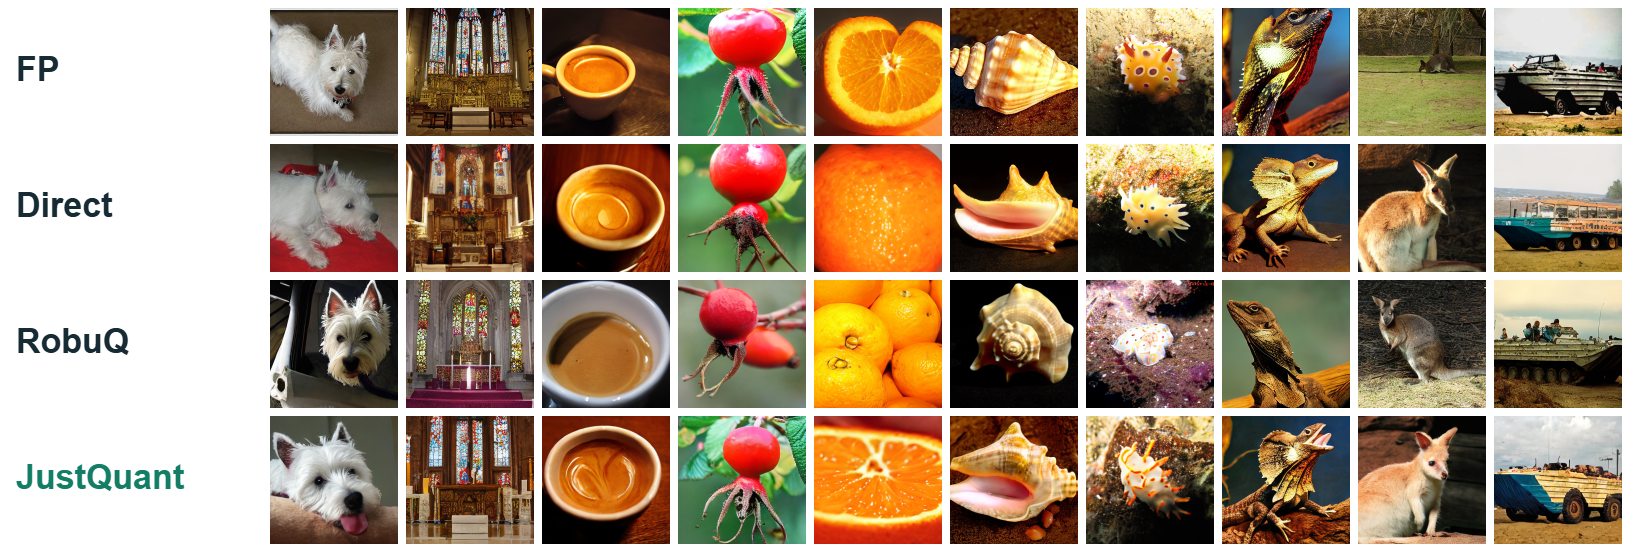
我们在 ImageNet 256 上测试了 DiT-XL/2。在 plain W4A4 下,JustQuant 达到 6.48 FID-10K,而 full-precision 参考结果是 6.78。在 W1.58A4 下,JustQuant 达到 3.30 FID-50K,同时恢复了低激活精度模型经常丢失的多样性,而且不需要 Hadamard rotation。
最后这一点很重要。一个模型如果只在很窄的一组样本上得到漂亮的 FID,却悄悄失去了探索分布的能力,那么它并没有真正变得更好。量化应该压缩表示,而不是压垮模型的想象力。
JustQuant 虽然最初是为低比特激活量化设计的,但它并不局限于这一种设置,也可以用于纯三值化蒸馏。在这一场景下,相比此前的 TerDiT,我们的方法实现了大幅加速,同时取得了更好的结果。也就是说,local-to-global 的蒸馏策略既能帮助 W1.58A4 这样的低比特激活模型,也能服务于纯三值化模型。
先局部,再全局
为什么渐进式蒸馏能帮助解决普通 QAD 不稳定的问题?论文中给出了三个相互关联的原因。
第一,训练稳定性。 激活量化会让优化过程天然变得不稳定。越长的低比特路径,包含的直通估计器(STE)近似就越多;如果一开始就进行端到端的全局蒸馏,多个近似误差会叠加,训练很容易直接失败。先从较短的量化片段开始,可以把优化控制在更稳定的范围内,再逐步扩大路径。
第二,模型对齐。 极低比特的参数不可能逐项精确匹配 full-precision 参数,但这些量化参数的组合仍然可以近似完整的变换。如果一开始就施加过度局部的目标,反而可能把 student 约束在一些它并不需要保留的中间数值上。真正需要对齐的,是组合起来的模型变换和最终行为,而不是每一个中间值。
第三,蒸馏密度。 越低层的目标暴露出越多中间状态,因此提供了更密集的监督,student 可以更快收到有用的更新。全局蒸馏只在最终输出处提供信号,是最稀疏的监督形式,也因此通常最慢、最难优化。局部目标让训练先获得足够密集的反馈,再逐渐把监督范围扩展到全局。
因此,JustQuant 从较短的量化片段开始,让它们匹配对应的 full-precision teacher 行为。当一个片段变得可靠之后,再扩大被监督的路径。目标始终是 teacher,但 student 解决的是一连串范围逐渐扩大的问题。
这就是我们称之为 local-to-global distillation 的原因。“local”并不意味着最终模型只学习局部目标,而是意味着训练信号先变得稳定、密集且可对齐,再逐步获得全局影响力。复杂度被移动到了训练阶段,而推理阶段仍然可以保持简单。
简单本身就是系统贡献
我们很容易把算子当成数学细节,把 kernel 当成实现细节。但在低比特推理中,这两者无法真正分开。算子决定了部署问题的形状。
普通 GEMM 的优势在于,它是模型和硬件之间的一种共同语言。不同厂商可以优化它、迁移它、映射到不同的指令集,而不需要改变训练方法。最好的 kernel 当然仍然有价值,但整个生态不必从零开始支持一种新的特殊算子。
这对最新 NVIDIA 显卡之外的硬件尤其重要。如果一家国产加速器厂商拥有高效的 W4A4 GEMM,那么 JustQuant 提供的模型推理图已经和它能够支持的硬件原语对齐。厂商不必先复现一个复杂的 SVD 加 rotation kernel,用户才有机会运行量化模型。
这是一种不同意义上的可迁移性。我们并不是承诺所有显卡都会得到完全相同的速度,而是希望模型只要求许多硬件都有可能提供的能力。
我们是不是在解决错误的问题?
回头看,我们或许花了太多时间研究如何让复杂的低比特算子变快,却没有同时追问:模型能不能学会避开这些算子?
这并不是对过去两年量化研究的否定。恰恰是那些方法告诉了我们低比特真正困难在哪里:outlier、激活分布、数值稳定性,以及 naive training 的边界。JustQuant 建立在这些经验之上。
但研究方向会产生惯性。一旦某个变换成为标准组件,我们就可能开始优化这个组件,而忘记重新审视整套方案。一个操作在数学上很优雅,并不意味着它应该出现在每一个部署模型里。
也许更值得问的问题不是“我们还能去掉多少 bit”,而是:
在我们真正拥有的硬件上,一个模型要保留自己的行为,最少需要哪些计算操作?
这条路可能带来什么
如果这个前提成立,它至少会带来几种影响。
第一,量化不必过度依赖某一家厂商的数值格式。NVFP4 等新表示非常令人兴奋,但如果方法的核心要求只是普通低比特 GEMM,它就有机会触达更多设备和更多用户。
第二,主流 CUDA 生态之外的硬件厂商会得到一个更清晰的目标。它们不必一次支持所有研究型算子;一条可靠的 W4A4 或 W1.58A4 路径,就可能已经足够解锁一批有用的模型。
第三,模型研究者可以把可部署性本身视为科学目标的一部分。一个结果不应只有压缩率和 benchmark 分数,还应该包含用户为了高效运行模型需要满足多少额外条件。
最后还有一个更哲学的问题:智能是否真的依附于模型的精确材料?如果一个模型可以从 dense floating-point 计算换成一系列普通的 4-bit 操作,同时保留自己的行为,那么我们称为“模型”的东西,或许更多地存在于计算的组织方式,而不在每一个数字的精度里。
这并不意味着精度不重要。它只是改变了问题。精度是一种材料,而训练过程决定了当材料改变时,哪些结构必须被保留下来。
接下来
JustQuant 不是低比特推理的终点。当前实验覆盖了一组图像模型和扩散语言模型,真正的部署仍然依赖权重打包、内存搬运、kernel 质量以及具体硬件细节。纯算子是一个更好的起点,但并不保证在所有设备上自动获得相同的速度。
我们希望以这样的方式推进项目。论文和项目页已经介绍了方法与结果;权重、训练代码、推理代码和复现实验材料正在准备中。
更大的愿望其实很简单:低比特模型应该可以变小,但不必因此变得奇异。如果一个模型能把自己的智能保存在普通算子里,那么更多人可以运行它,更多硬件可以支持它,论文结束之后也会有更多研究真正发生。
也许这才是量化方法更重要的衡量标准:不是为了让模型变小而增加了多少机器,而是一个模型要保持自己,究竟需要多么少的机器。